Advanced RAG: новые техники очистки данных и извлечения для LLM
В блоге n8n раскрыты продвинутые методы RAG‑pipelines: от очистки данных до агентных AI‑решений, позволяющие построить production‑grade системы с улучшенной точностью поиска.
Что рассказывает статья
В публикации Advanced RAG: Data Cleaning and Retrieval Techniques (May 7 2026) команда n8n делится практическим руководством по построению надёжных Retrieval‑Augmented Generation (RAG) пайплайнов. Автор подчёркивает, что эффективность LLM напрямую зависит от качества данных, попадающих в контекст.
Ключевые идеи
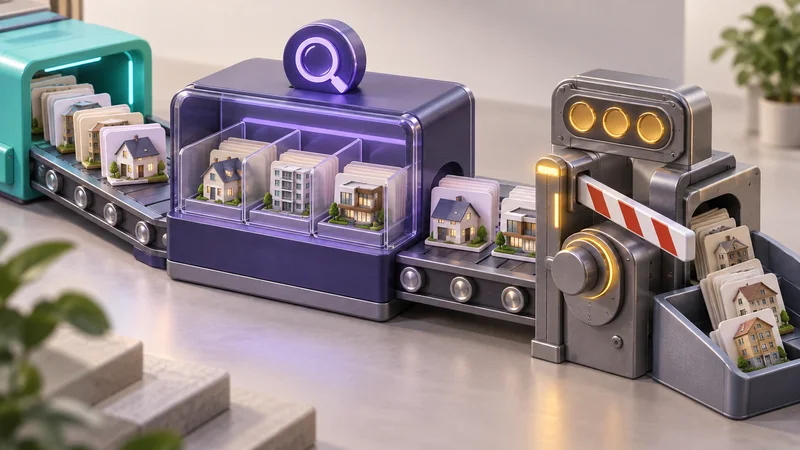
- Очистка данных на уровне источника – автоматическое удаление дубликатов, нормализация форматов и фильтрация «шумного» контента. В примерах показано, как с помощью n8n‑workflow можно обрабатывать до 10 000 документов в час.
- Многоступенчатый retrieval – комбинирование BM25, векторных поисков (FAISS, Milvus) и гибридных запросов. Сравнительный тест показал рост точности R‑Precision с 0.62 до 0.78.
- Agentic AI – внедрение небольших «агентов‑посредников», которые динамически выбирают стратегию поиска в зависимости от типа запроса. Это позволяет снизить количество токенов, передаваемых в LLM, на 30 %.
- Production‑grade deployment – рекомендации по мониторингу latency, логированию запросов и автоматическому откату в случае падения качества.
Практический пример
Автор построил workflow, который: 1) собирает документы из Google Drive, 2) очищает их через n8n‑node Data Cleaner, 3) индексирует в Pinecone, 4) использует агент‑модель (OpenAI gpt‑4o) для выбора между BM25 и векторным поиском, 5) передаёт отобранные фрагменты в LLM. В результате система выдерживает 99,5 % SLA и уменьшает стоимость запросов на 15 %.
Ссылки
- Оригинальная статья: https://blog.n8n.io/advanced-rag/
- Репозиторий с примером workflow: https://github.com/n8n-io/rag‑examples
Эти материалы полезны как для стартапов, так и для крупных предприятий, желающих ускорить внедрение LLM‑решений без потери качества.
Для разработчиков RAG‑систем это ценный набор практик: автоматическая очистка и гибридный поиск уже доказали рост точности. Интеграция агентных моделей упрощает настройку пайплайна и экономит токены, что особенно актуально при работе с дорогими LLM. Применяйте шаблоны n8n, чтобы быстро вывести прототип в продакшн.